一起来看一下成品:
准备工具
seedaudio 1.0 https://ark.volcengine.com/
ChatGPT/豆包/gemini(推导提示词) https://chatgpt.com/c/
https://www.flowpix.club/bj/38528.html?token=905f5dcd47c6c3d4b9f66710dc08414c
SeedAudio 1.0能做什么?
传统TTS配音通常只能选择音色,再添加开心、悲伤、生气等简单情绪。
但真正的人物表演并不是固定情绪。
同一句话里,人物可能先保持平静,随后产生怀疑,接着提高语速,最后因为委屈而停顿。
SeedAudio 1.0的优势,是可以将人物状态、情绪变化、停顿、呼吸、环境声音和具体台词写在同一段提示词中。
它不只是让人物“读台词”,而是让人物在具体场景中完成表演。
这篇教程将分为五章:
第一章:创建参考音色;
第二章:人物情绪与状态表演;
第三章:生成完整环境音效;
第四章:多角色对话与角色分配;
第五章:制作一段完整有声剧。
第一章:创建参考音色
seedaudio在哪里可以使用呢?
我这里提供2个网址
1.火山方舟(可以免费体验生成几分钟) https://ark.volcengine.com/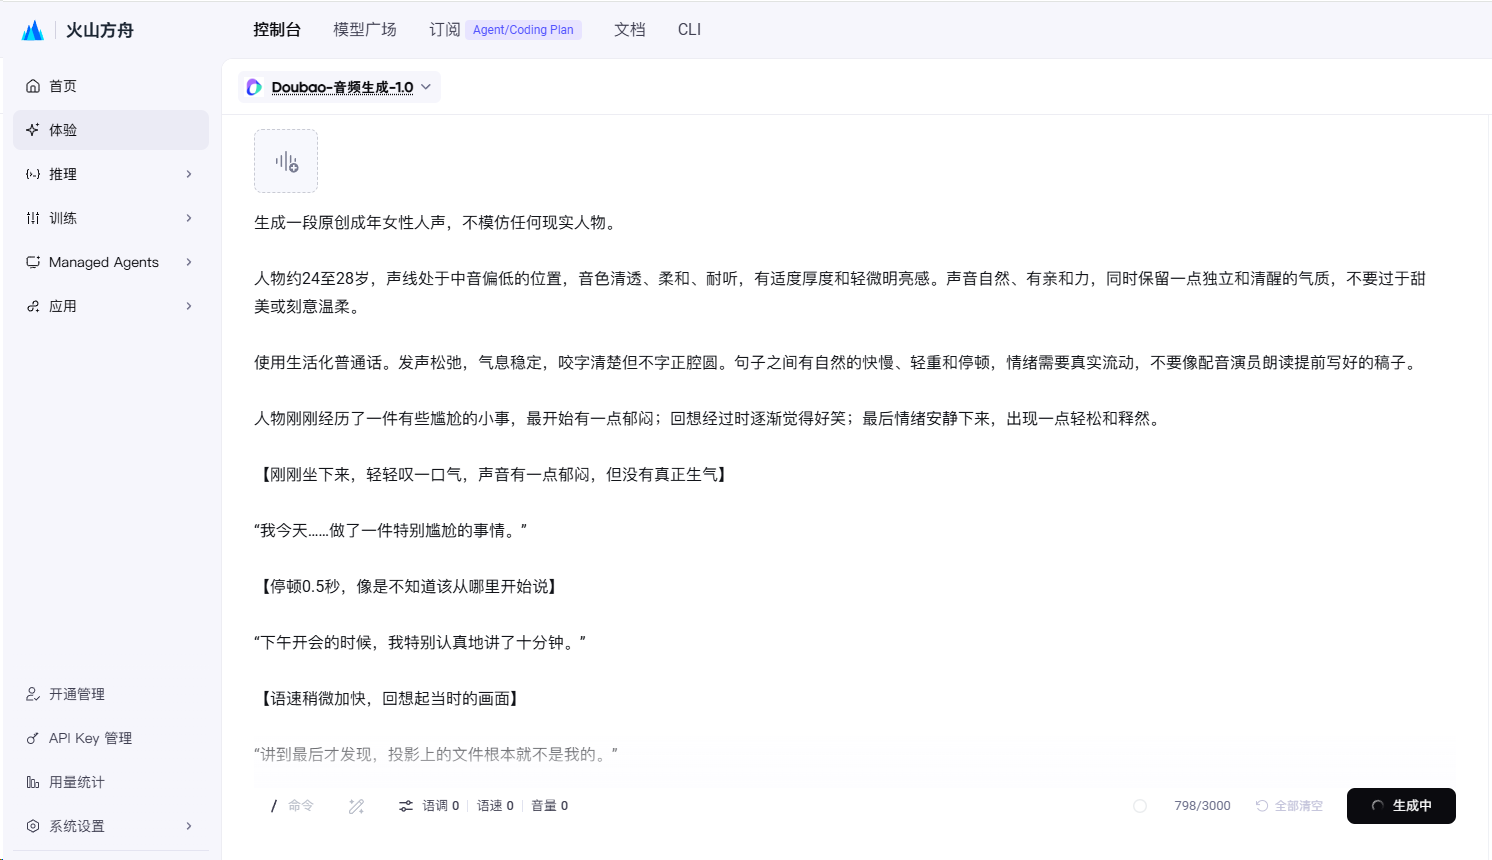
2.flowpix https://www.flowpix.club/点击创建生成音频即可
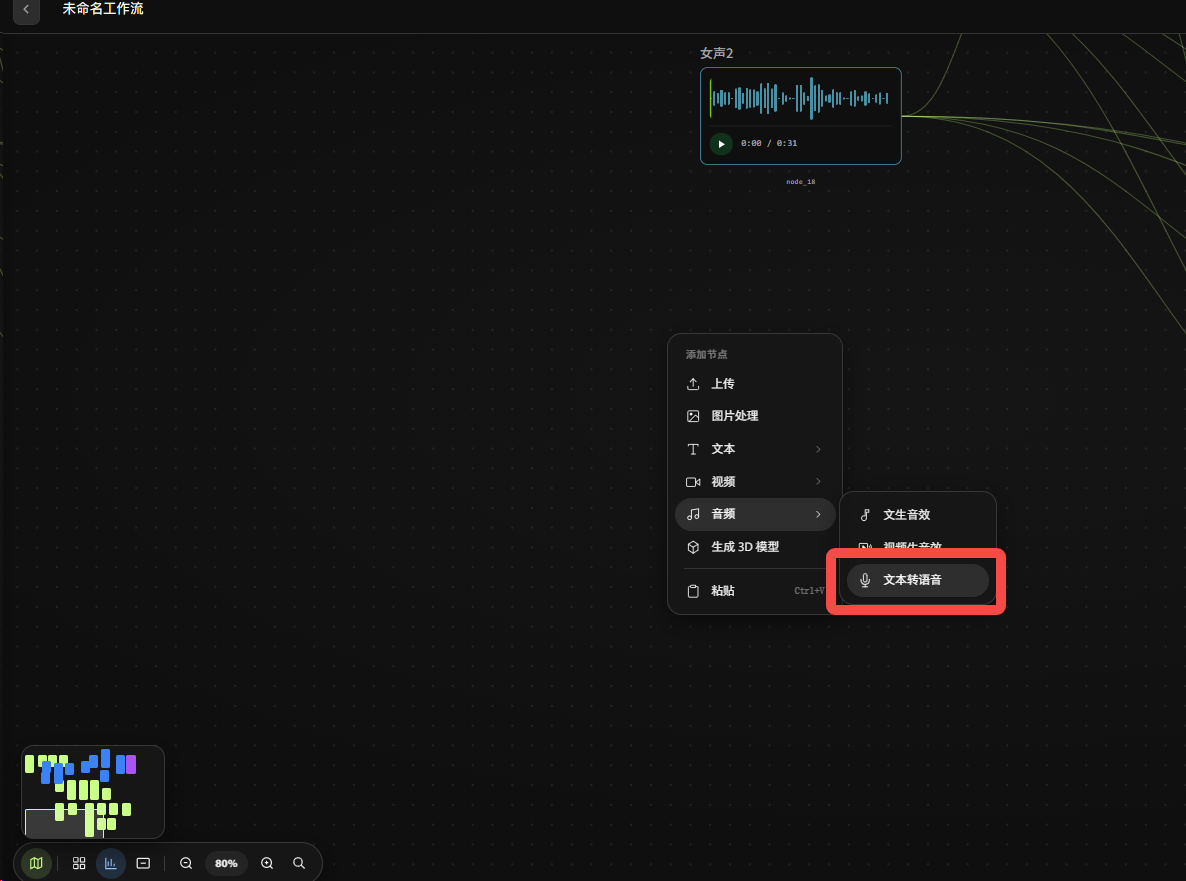
在制作有声书、多角色短剧和视频配音之前,需要先建立稳定的人物声音。
参考音色不是简单生成一段好听的人声,而是建立一个可以反复使用的“声音角色”。
后面即使改变台词、情绪和录音环境,人物的年龄感、声线、声音厚度和辨识度也应该保持一致。
参考音色生成模板(修改后直接发给大语言模型就行)
只需要修改以下五项:
【性别】 【年龄】 【声线】 【音色气质】 【主要用途】
生成一段原创【性别】参考音色,不模仿任何现实人物。
人物约【年龄】岁,声线【声线特点】,音色【音色气质】,整体自然、好听、松弛,有真实的人声质感,适合用于【主要用途】。
请自动创作一段20至30秒的生活化独白。内容围绕一件日常发生的小事,台词自然、有画面感,不要像提前写好的文案。
人物最开始保持自然状态,中间因为回想起某个细节产生明显的情绪变化,最后逐渐放松。请自动将人物状态、停顿、呼吸、语速和情绪变化穿插在台词之间。
使用生活化普通话,咬字清楚但不要字正腔圆。语调需要有自然的轻重和快慢变化,允许出现轻微呼吸、犹豫和笑意,不要让每句话使用相同节奏。
录音环境安静,人物距离麦克风较近。不要背景音乐、环境音、明显混响和其他人物声音。
不要播音腔、朗诵腔、客服腔、短视频营销腔、情感电台腔和AI逐字朗读感。整段保持同一个年龄感、同一个声线和稳定的核心音色。
本次一共创建三个角色:
林夏:女性主角,声音清透、柔和,情绪细腻;
我的提示词如下:
&生成一段原创成年女性人声,不模仿任何现实人物。
人物约25岁,声线偏中低,音色清透、柔和、耐听,有适度的声音厚度和轻微明亮感。发声松弛自然,气息稳定,声音有亲和力,但不要过分甜美、刻意温柔或故意压低嗓音。
使用生活化普通话,咬字清楚但不字正腔圆。句子有自然的轻重、快慢和呼吸变化,不要每句话都使用相同的语调。整体像一个声音条件很好的人,在安静的房间里和熟悉的人分享今天发生的事情。
人物最开始有一点疲惫,随后因为想起一件小事而变得轻松,最后出现一点若有所思。情绪自然流动,不要明显表演,不要播音腔、朗诵腔、客服腔和AI逐字朗读感。
台词与状态:
【刚刚忙完一天,轻轻呼出一口气,声音有一点疲惫,但整体放松】
“我今天……其实过得有点乱。”
【短暂停顿,像是在回想白天发生的事情】
“一早出门的时候忘了带钥匙,走到楼下才突然想起来。”
【想到当时的画面,语气变得轻松一些,带一点无奈的笑意】
“然后我又拎着一大堆东西,重新跑上楼。”
【自然地笑一下,声音明亮一点,但不要真的大笑】
“当时真的觉得自己特别傻。”
【停顿0.5秒,情绪慢慢安静下来】
“不过后来想想……”
【语速放慢,语气变得柔和,像在认真分享自己的感受】
“好像每天都会发生一些不在计划里的事情。”
【轻微吸气,句尾自然变轻,带一点释然】
“也不一定是坏事,对吧?”
录音环境安静、干净,人物距离麦克风较近。不要背景音乐、环境音、明显混响和其他人物声音。
周沉:成年男性,声音沉稳、克制;
我的提示词如下:
生成一段原创成年男性人声,不模仿任何现实人物。
人物约28至32岁,声线偏中低,音色干净、沉稳,有适度厚度和轻微颗粒感,但不要沙哑、烟嗓或故意压低声音。声音听起来可靠、松弛,有成熟感,但不要显得年龄过大。
使用自然、生活化的普通话。咬字清楚但不刻意,语调有真实的轻重和快慢变化。说话时情绪比较克制,不使用播音腔、纪录片旁白腔、霸总腔或短视频配音腔。
人物刚结束一天的工作,开始有些疲惫。说起白天发生的事情时带一点无奈,随后情绪逐渐放松,最后出现轻微的期待感。
【刚刚坐下来,轻轻呼出一口气,声音有些疲惫,但整体依然松弛】
“今天……好像比平时长了很多。”
【短暂停顿,像是在回想白天发生的事情】
“一早刚到公司,原本安排好的事情就全被打乱了。”
【语速稍微加快,带着一点无奈和自嘲】
“开了三个会,改了五遍方案,最后发现……第一版其实就挺好的。”
【轻轻笑一下,不要发出明显笑声,声音逐渐放松】
“有时候真的不知道,我们到底是在解决问题……”
【停顿0.5秒,语气带一点调侃】
“还是在给自己制造新的问题。”
【轻轻吸气,情绪慢慢安静下来,语速放缓】
“不过回来的路上,风还挺舒服的。”
【声音变得柔和一些,带有轻微期待】
“突然觉得,今天也没有想象中那么糟。”
【句尾自然收住,像是在对熟悉的人说话】
“明天……应该会好一点吧。”
人物距离麦克风较近,录音环境安静、干净。允许出现自然呼吸和微小停顿,但不要加入明显口水音、喷麦声或夸张气声。
不要背景音乐、环境音、混响和其他人物声音。不要磁性电台腔、油腻低音、气泡音、客服腔、朗诵腔和AI逐字朗读感。整段保持同一个人物、同一个年龄感和同一个核心音色。
程瑶:年轻女性,声音明亮、自然,情绪更加外露。
我的提示词如下:
生成一段原创成年女性人声,不模仿任何现实人物。
人物约24至28岁,声线处于中音偏低的位置,音色清透、柔和、耐听,有适度厚度和轻微明亮感。声音自然、有亲和力,同时保留一点独立和清醒的气质,不要过于甜美或刻意温柔。
使用生活化普通话。发声松弛,气息稳定,咬字清楚但不字正腔圆。句子之间有自然的快慢、轻重和停顿,情绪需要真实流动,不要像配音演员朗读提前写好的稿子。
人物刚刚经历了一件有些尴尬的小事,最开始有一点郁闷;回想经过时逐渐觉得好笑;最后情绪安静下来,出现一点轻松和释然。
【刚刚坐下来,轻轻叹一口气,声音有一点郁闷,但没有真正生气】
“我今天……做了一件特别尴尬的事情。”
【停顿0.5秒,像是不知道该从哪里开始说】
“下午开会的时候,我特别认真地讲了十分钟。”
【语速稍微加快,回想起当时的画面】
“讲到最后才发现,投影上的文件根本就不是我的。”
【短暂停顿,带着明显的无奈和一点不敢相信】
“最离谱的是……”
【声音稍微明亮一些,开始觉得这件事有点好笑】
“他们居然没有一个人提醒我。”
【自然地笑一下,但不要发出夸张笑声】
“所有人就坐在那里,特别认真地点头。”
【停顿0.6秒,情绪逐渐放松下来】
“当时我真的很想找个地方躲起来。”
【轻轻呼出一口气,语速放慢,语气变得柔和】
“不过现在想想……”
【带着一点释然和自我调侃】
“好像也没什么大不了的。”
【句尾自然变轻,像是在和熟悉的人分享秘密】
“至少以后,他们应该会记得我了。”
人物距离麦克风较近,录音环境安静、干净。允许出现自然呼吸、犹豫和轻微笑意,但不要出现固定的甜美语调。
不要夹子音、幼态少女音、过度御姐音、烟嗓、明显气声、撒娇腔、客服腔、情感电台腔和AI逐字朗读感。不要背景音乐、环境音、混响和其他人物声音。整段保持同一个人物、同一个年龄感和稳定的核心音色。
第二章:人物情绪与状态表演
第一章中,我们已经为角色建立了稳定的参考音色。
但是,一个音色能不能真正用于有声剧、短剧和视频配音,不只要看声音是否好听,还要看它在改变情绪和身体状态之后,能不能继续保持同一个人物的声音。
这一章继续使用林夏的参考音色,分别生成轻松调侃、压抑愤怒和担心委屈三种状态。
统一剧情设定:
林夏和一个非常在意的人约好见面,对方迟到了将近一个小时,也没有回复任何消息。
她终于看到对方出现,压在心里的情绪开始流露。
状态一:轻松调侃
保持人物原本的年龄感、声线、声音厚度、发声位置和自然说话习惯。整段始终是同一个人,情绪和身体状态只能改变呼吸、语速、音量、停顿和语气,不能改变人物的核心音色。
看到对方终于出现后,她先明显松了一口气。因为不想让气氛变得尴尬,她故意用开玩笑的方式抱怨,语气中带着一点无奈、一点亲近和一点故意逗对方的感觉。
整体声音松弛、自然、有生活感。情绪需要有变化,不能从头到尾保持同一个轻快语调。不要撒娇,不要夹子音,不要短视频式夸张表演。
【看到对方从远处走过来,原本有些焦急,发现对方没事后,轻轻松了一口气】
“你终于来了……”
【停顿0.5秒,看着对方走近,语气慢慢轻松下来】
“我刚才都已经开始怀疑,是不是自己把时间记错了。”
【像是拿出手机确认时间,语速稍微加快,带一点无奈的笑意】
“我还来来回回看了三遍聊天记录。”
【停顿0.4秒,故意加重“你”】
“结果时间没错,地点也没错……”
【像是终于找到真正的原因,语气带着调侃】
“错的是你。”
【短暂停顿,嘴角带着笑意,但不要真的笑出声】
“你知道我在这里等了多久吗?”
【故意停顿0.6秒,让对方猜】
“整整五十七分钟。”
【“五十七分钟”稍微加重,像是在认真计较,但整体仍然轻松】
“再晚三分钟,我就准备给你发寻人启事了。”
【轻轻呼出一口气,情绪放松下来】
“不过算了……”
【语气变得自然、亲近,像是不打算真的追究】
“人来了就行。”
【看了对方一眼,带着一点真实的小埋怨】
“下次再迟到,至少提前告诉我一声。”
【停顿0.4秒,语气重新变得轻松】
“走吧,我都快饿死了。”
【最后一句语速稍快,恢复自然聊天状态,句尾干净收住】
人物情绪变化:
先担心对方是否出事,看到对方后松一口气,再用调侃掩饰等待太久的不满,最后恢复亲近和轻松。
不要大笑,不要过分甜美,不要撒娇。调侃感主要通过重音、短暂停顿、语速变化和轻微笑意表现。
不要背景音乐、环境音和其他人物声音。
状态二:压抑愤怒
保持人物原本的年龄感、声线、声音厚度、发声位置和自然说话习惯。整段始终是同一个人,情绪和身体状态只能改变呼吸、语速、音量、停顿和语气,不能改变人物的核心音色。
看到对方出现后,她并没有立刻发火,而是努力让自己保持冷静。前半段声音偏冷、语速较慢、句尾收得很短;随着台词推进,积压的不满逐渐增加。中段语速加快,重音变得明显;说到最在意的事情时出现一次短暂爆发,随后重新压低声音。
不要从第一句就怒吼。需要表现人物从克制到忍不住,再重新控制情绪的完整过程。
【看到对方出现,没有立刻说话,先保持1秒沉默】
【轻轻吸气,努力控制情绪,声音偏冷】
“你终于来了。”
【句尾直接收住,不带疑问,也没有轻松感】
【停顿0.8秒,看着对方,像是在等待一句解释】
“我从九点五十开始,就一直站在这里等你。”
【语速稳定,但“九点五十”和“一直”稍微加重】
“给你发了六条消息。”
【短暂停顿】
“打了四个电话。”
【停顿0.5秒,声音压低,情绪开始变得更重】
“你一条都没有回。”
【轻轻吸气,像是继续忍住情绪】
“我原本还在想,你是不是路上出了什么事。”
【语速略微加快,压抑的不满逐渐浮现】
“我甚至已经准备去附近找你了。”
【停顿0.7秒,看到对方毫无解释,语气明显变冷】
“可你现在就这样走过来……”
【“就这样”明显加重】
“连一句为什么迟到都不准备说,是吗?”
【停顿1秒,等不到回应,情绪开始失控】
“你知道我最生气的是什么吗?”
【音量略微提高,但不要喊】
“不是你迟到了!”
【短暂停顿,第一次出现明显爆发】
“是你明明知道我在等你,却连一句消息都不愿意发!”
【爆发后轻微换气,声音重新压低,但仍然带着怒意】
“哪怕你只告诉我一句,让我别等了……”
【语速放慢,愤怒中开始出现失望】
“我也不会像个傻子一样,一直站在这里。”
【停顿0.8秒,努力重新控制情绪】
“算了。”
【声音明显变轻,但不是释然,而是已经不想继续争论】
“我现在不想听你解释。”
【最后一句平静、冷淡,句尾直接收住】
“你让我一个人待一会儿。”
人物情绪变化:
最开始极力克制,随后通过事实陈述不断积累不满,在“不是你迟到了”之后短暂爆发,最后因为失望重新冷静下来。
愤怒主要通过重音、停顿缩短、语速加快和短暂提高音量表现。不要全程吼叫,不要咬牙切齿,不要冷笑,不要让声音突然变得沙哑或低沉。
不要背景音乐、环境音和其他人物声音。
状态三:担心转为委屈
保持人物原本的年龄感、声线、声音厚度、发声位置和自然说话习惯。整段始终是同一个人,情绪和身体状态只能改变呼吸、语速、音量、停顿和语气,不能改变人物的核心音色。
人物已经等待了很久。她最开始并不是生气,而是一直担心对方是不是遇到了危险。看到对方平安出现后,她先松了一口气,但此前积压的担心、害怕和委屈同时涌上来。
前半段仍然努力维持正常说话;中段情绪逐渐不稳定,呼吸变浅,停顿增加;说到自己一直担心对方时,声音明显发抖;后半段终于忍不住掉眼泪,但不要大哭、哭喊或连续抽泣。
情绪需要从“松一口气”逐渐转向“无法理解”,再转向“委屈和失望”。
【看到对方出现,先明显松了一口气,轻轻呼出一口气】
【声音很轻,像是仍然不敢相信】
“你终于来了……”
【停顿0.7秒,仔细看了对方一眼,确认对方没有受伤】
“你没事,对吧?”
【声音里带着真实的担心,语速稍快】
“你有没有哪里不舒服?路上是不是出了什么事?”
【发现对方一切正常,停顿1秒,情绪突然变得复杂】
“没有吗……”
【轻轻吸气,声音慢慢降低】
“那你为什么一直不接电话?”
【停顿0.6秒,努力维持正常语气】
“我给你打了四次。”
【声音开始轻微发抖】
“每一次没人接,我都在想……”
【停顿0.8秒,呼吸变浅,像是很难继续说下去】
“是不是发生了什么特别不好的事情。”
【轻轻吸气,努力忍住眼泪】
“我甚至不敢离开这里。”
【语速变慢,委屈逐渐明显】
“我怕你来了以后找不到我。”
【停顿1秒,眼泪开始涌上来,声音明显不稳定,但仍然尽量说清楚】
“可你现在站在这里……”
【短暂停顿,带着不理解】
“看起来什么事都没有。”
【轻微吸气,声音变得更轻】
“你是不是根本就没有想过……”
【停顿0.7秒,最后几个字轻微发颤】
“我会担心你?”
【保持1秒沉默,努力把情绪压回去,但没有成功】
“我不是因为你迟到才难过。”
【声音中开始出现轻微哭腔,不要大哭】
“我是觉得……”
【中途停顿,轻轻吸鼻子一次,不要夸张】
“我好像一直都在很认真地对待我们说好的事情。”
【声音降低,委屈达到最高点】
“可你没有。”
【停顿1秒,眼泪落下后,声音反而逐渐安静】
“算了……”
【轻轻呼吸,语速很慢,带着疲惫和失望】
“你平安就好。”
【最后一句声音很轻,像是不想让对方看到自己继续失控】
“我先回去了。”
【说完后保持1秒安静,只保留一次轻微、不稳定的呼吸】
人物情绪变化:
看到对方后先松一口气,随后发现对方并没有遇到危险,从担心转为无法理解;说出自己一直不敢离开时,委屈逐渐积累;在“我好像一直都在很认真”处情绪达到最高点;最后不是继续哭,而是疲惫地结束对话。
不要一开口就哭。不要持续抽泣,不要哭喊,不要把声音变得幼态或尖细。哭腔只能出现在后半段,并且要保留人物原本的声线和年龄感。
不要背景音乐、环境音和其他人物声音。
本章生成音频的作用
这三段音频主要有2个作用。
首先,用来测试参考音色的表演能力。
同一个人物在改变情绪后,声音的年龄感、声线和核心音色应该保持一致。变化的应该是语速、音量、呼吸、重音和停顿,而不是直接变成另一个人的声音。
其次,用来观察不同提示词对情绪的控制效果。
轻松调侃主要依靠语速变化、轻微笑意和特殊重音;
压抑愤怒主要依靠停顿、语气变冷、重音增加和短暂提高音量;
担心委屈主要依靠呼吸不稳定、语速变慢、声音降低和轻微哭腔。
通过三段对比,可以更直观地判断哪些提示词真正影响了人物表演。
第三章:生成完整环境音效
前两章解决了人物声音和情绪表演的问题,但只有对白的音频,听起来依然会像一段单独录制的配音。
真正完整的有声剧/影视,还需要雨声、脚步声、办公室底噪、人群声和空间回声等环境声音,帮助听众判断人物在哪里,以及场景正在发生什么。
SeedAudio 1.0除了生成人物对白,还可以根据场景描述生成一段完整环境声音。
不需要编写复杂的时间轴,也不需要规定每一秒出现什么声音。
只需要写清楚场景、空间、主要声音、远近关系和排除项。
演示一:雨夜城市街道
生成一段写实的雨夜城市街道环境音。
夜晚正在下中雨,雨水持续落在道路、汽车顶部和街边遮雨棚上,形成不同材质的雨声。近处偶尔有车辆驶过湿润路面,轮胎带起明显水声;远处持续传来城市交通声和模糊鸣笛声。
街道上行人较少,偶尔出现快速经过的脚步声和雨伞轻微晃动声。整个空间开阔,声音具有自然的远近层次。
整体氛围安静、真实,雨声是主要声音,但不能过于密集或刺耳。
不要人物对白,不要旁白,不要背景音乐,不要雷声,不要夸张电影音效。
演示二:下午咖啡馆
生成一段自然、舒适的下午咖啡馆环境音。
场景是一家面积不大的城市咖啡馆。近处偶尔传来咖啡杯放在木桌上的轻响、餐具碰撞声、纸张翻动声和椅子轻微移动声。
中间区域有几桌顾客正在低声交谈,只需要形成模糊的人声氛围,不能听清具体内容。远处偶尔出现咖啡机运行、蒸汽喷出和店门打开的声音。
整体空间温暖、松弛,有适度的室内混响,但声音不能过于嘈杂。所有声音自然出现,不要连续重复同一种音效。
不要清晰人物对白,不要旁白,不要背景音乐,不要刻意加入鸟叫或街道噪音。
演示三:深夜办公室
生成一段安静、真实的深夜办公室环境音。
场景是一间较大的开放式办公室,大部分员工已经离开。空间中持续存在轻微的空调运转声、电脑主机低频声和灯具细小电流声。
近处偶尔出现键盘输入、鼠标点击、纸张翻动和办公椅轻微移动的声音。远处偶尔传来电梯到达提示音,以及走廊中短暂经过的脚步声。
整个办公室非常安静,各种声音之间保留较多空白,不要持续堆叠音效。声音具有明显的室内距离感和轻微空间回声。
不要人物对白,不要背景音乐,不要电话铃声,不要突然出现强烈声音。
生成音效的作用
首先,环境音可以快速建立场景。
即使没有画面,听众也能通过雨水落在遮雨棚上的声音、湿地上的车辆声和远处交通声,判断人物正处于雨夜街道。
咖啡机、杯碟碰撞和模糊交谈声,则可以让人迅速进入咖啡馆环境。
其次,环境音可以增强声音的空间感。
通过区分近处、中间和远处的声音,可以让音频不再只是平面的声音堆叠。
例如近处是键盘输入声,中间是空调和电脑运转声,远处是电梯提示音和走廊脚步声,听众就能感受到办公室的面积和人物所处的位置。
第三,环境音可以推动剧情。
脚步声逐渐靠近,说明有人正在接近;
房门突然关闭,说明人物被困在空间中;
手机振动、车辆停靠和玻璃碎裂,也可以在没有旁白解释的情况下传递剧情信息。
第四,单独生成环境音方便后期调整。
如果人物对白、环境音和关键音效全部一次生成,某个声音不合适时,往往需要重新生成整段内容。
将环境音单独生成后,可以在剪辑软件中自由调整音量、长度、出现位置,也能更方便地替换失败的声音。
第五,这些结果可以建立可重复使用的声音素材库。
可以将生成结果分别保存为:雨夜城市街道;下午咖啡馆;深夜办公室;传统集市;医院走廊;公寓楼道。
后续制作有声剧、短剧配音或视频时,遇到相似场景就可以直接复用,不需要每次重新生成。
第四章:多角色对话与角色分配
前三章已经完成了角色参考音色、人物情绪表演和环境音效。
接下来需要把不同角色放进同一个场景中,测试模型能否准确识别人物身份,并按照剧本分配对应的声音、情绪和空间位置。
这一章使用林夏、周沉和程瑶三个参考音色,制作一段短篇多人对话。
演示案例:《这份外卖不是我点的》
深夜,林夏收到一份外卖,但房间里的程瑶表示自己没有下单。
外卖员周沉准备离开时,突然看到订单备注:
不要让她回屋,房间里的人不是程瑶。
完整提示词
使用三个人物的参考音色进行配音。
林夏使用【音色1】,周沉使用【音色2】,程瑶使用【音色3】。三个角色的声音不能交换,保持各自稳定的年龄感、声线和说话习惯。
场景是深夜公寓门口。林夏和外卖员站在门外,程瑶最开始位于房间深处。背景只有轻微室内底噪和走廊环境声,不要背景音乐。
【响起两次轻轻的敲门声】
【林夏打开门,带着疑惑,语气自然】
林夏:
“你好,可是我没有点外卖啊。”
【周沉站在门外,低头确认订单,语气礼貌、沉稳】
周沉:
“地址是三栋302,收件人叫程瑶。”
【程瑶从房间深处回应,声音距离较远,带着一点随意】
程瑶:
“不是我的,我今晚什么都没点。”
【林夏回头看向房间,语气更加疑惑】
林夏:
“那是不是送错了?”
【周沉准备离开,突然看到订单备注,停顿0.8秒】
【声音降低,语气从礼貌变得严肃】
周沉:
“等一下……”
【停顿0.5秒,确认备注内容】
“订单上还有一句话。”
【林夏轻轻吸气,产生不安】
林夏:
“写了什么?”
【周沉压低声音,语速变慢】
周沉:
“不要让她回屋。”
【停顿0.6秒】
“房间里的人……不是程瑶。”
【走廊短暂安静】
【真正的程瑶从林夏身后很近的位置轻声开口】
程瑶:
“你们在说什么?”
【林夏突然屏住呼吸】
【房门自动关闭,音频立即结束】
本章生成音频的作用
首先,多角色对话可以测试参考音色的角色分配能力。
当一段音频中同时出现多个角色时,模型需要准确判断哪一句属于林夏、哪一句属于周沉、哪一句属于程瑶,不能在中途交换人物声音。
其次,可以测试角色音色的连续稳定性。
同一个角色通常会在一段剧情中多次开口。即使中间插入了其他人物的台词,再次出现时,也应该保持相同的年龄感、声线和声音气质。
第三,可以建立人物之间的表演关系。
多人对话并不是把几段单人配音简单拼接在一起。一个人物说话时,另一个人物可能正在犹豫、打断、回应或压低声音。
通过台词顺序、停顿和情绪反应,可以让三个角色真正处于同一个场景中。
第四,可以表现人物的空间位置。
角色从房间深处说话时,声音应该更远、更模糊;
人物靠近门口后,声音会逐渐清晰;
声音突然出现在主角身后时,则需要明显缩短距离。
这种距离变化可以帮助听众在没有画面的情况下,判断角色正在移动或改变位置。
第五章:制作完整有声剧
前四章分别解决了角色声音、人物表演、环境音效和多人对话问题。
最后一章将这些能力组合在同一段音频中,制作一段完整的有声剧。
这一章不再单独测试某一个功能,而是观察多个功能同时出现时,模型能否维持人物、情绪、剧情和声音环境的整体稳定。
完整提示词如下:
林夏使用【音色1】,周沉使用【音色2】,程瑶使用【音色3】。三个角色的声音不能交换,保持各自稳定的年龄感、声线和说话习惯。
使用三个人物的参考音色制作一段情绪强烈的灾难有声剧。
三个角色的核心音色、年龄感和声音身份必须始终保持一致。人物情绪可以影响呼吸、音量、语速、停顿和声音稳定度,但不能更换人物声线。
场景是一栋正在燃烧的办公楼。楼内持续存在火焰燃烧、远处报警器、建筑轻微震动和烟雾造成的闷响。楼外有消防车辆、模糊人群声和远处警报声。
环境音需要有空间层次,但不能遮挡人物对白。不要背景音乐。
【开头是持续的火焰燃烧声,远处报警器断断续续响起】
【林夏捂住口鼻,呼吸急促,努力压低身体向前移动,声音发紧】
林夏:
“我看不见出口……”
【短促换气,咳嗽一次,努力让自己保持清醒】
“周围全是烟,我不知道自己现在在哪一层。”
【电话中的周沉声音清晰、沉稳,语速稍快,但没有慌乱】
周沉:
“听着,先不要站起来。”
【语气坚定,每个指令都说得清楚】
“趴低,沿着右边的墙一直往前走。”
【短暂停顿,确认林夏还在听】
“不要挂电话,我马上到你那里。”
【林夏向前移动,远处响起物体倒塌声,她被吓到,呼吸突然失控】
林夏:
“前面过不去了!”
【声音明显颤抖,语速加快】
“天花板掉下来了,我没有路了!”
【周沉听见倒塌声后,声音第一次明显提高,但仍然清晰】
周沉:
“林夏,看着手机!”
【短暂停顿,语气强硬,试图把她从恐惧中拉回来】
“你左边有没有门?哪怕是一扇小门!”
【林夏剧烈咳嗽,摸索周围,声音接近哭出来】
林夏:
“有……有一扇。”
【急促呼吸,尝试推动房门】
“可是打不开!”
【楼外,程瑶抢过电话,声音焦急,带着明显哭腔】
程瑶:
“姐!”
【短暂停顿,哭着吸气,语速很快】
“你听见我了吗?你别怕,消防员已经上去了!”
【声音开始发抖,努力把话说完整】
“你再坚持一下,求你了……”
【林夏听见妹妹的声音后短暂安静,情绪从恐惧变成强烈的不舍】
林夏:
“程瑶……”
【轻轻吸气,声音很虚弱,但努力显得平静】
“你先别哭。”
【短暂停顿,火焰声逐渐变大】
“我答应你的事情,还没做完呢。”
【程瑶情绪彻底失控,声音提高,哭着打断】
程瑶:
“那你就出来啊!”
【急促换气,几乎喊出来】
“你自己答应我的,你不能又说话不算数!”
【周沉快速向前移动,近处出现急促脚步和装备碰撞声】
【周沉隔着门大声呼喊,声音比电话中更远,但更有力量】
周沉:
“林夏!退后!”
【停顿0.5秒】
“离开房门!”
【林夏听见周沉的声音,重新出现希望,急促向后移动】
林夏:
“我在这里!”
【带着哭腔,提高音量】
“我在门后面!”
【周沉猛烈撞击房门一次】
【建筑内部突然传来沉重的断裂声】
【周沉立刻提高音量,急促喊出】
周沉:
“趴下!”
【巨大的坍塌声突然响起,电话信号出现强烈杂音】
【所有人物声音突然中断】
【楼外环境中,程瑶愣住,呼吸停止片刻】
程瑶:
“姐?”
【停顿1秒,只剩下电话电流声】
【程瑶声音很轻,已经完全失去刚才的力量】
“姐……你说话啊。”
【电话中突然传来两声微弱敲击】
【程瑶屏住呼吸】
【周沉的声音从电话中断断续续传来,急促但坚定】
周沉:
“她还活着。”
【短暂停顿,周沉用力推动障碍物】
“继续和她说话!”
【程瑶立刻靠近电话,声音仍然哭泣,但重新出现希望】
程瑶:
“姐,你听见了吗?”
【深吸一口气,努力让声音稳定】
“我就在这里。”
【语速放慢,哭着重复】
“你别睡,我一直陪着你。”
【远处继续传来消防员清理障碍的声音,音频结束】
本章生成音频的作用
首先,完整有声剧可以检验前面所有步骤是否真正能够组合使用。
参考音色需要保持稳定;
不同角色需要准确分配;
人物情绪需要随着剧情推进;
环境音需要建立场景;
提示音和脚步声需要推动剧情。
任何一个环节出现问题,都会影响最终成片。
其次,可以测试短时间内的情绪转折。
完整剧情中的人物不会一直保持一种状态。
这种连续变化比单独生成一种情绪更接近真实剧情表演。
第三,可以检验不同角色之间的情绪影响。
角色的情绪不再独立存在,而是会随着其他人物的台词产生即时反应。
第四,可以检验环境音与对白的融合能力。
环境音既不能完全消失,也不能抢占剧情重点。
结语
SeedAudio 1.0的价值,不只是让AI声音变得更加真实。
更重要的是,它开始将人物音色、情绪表演、环境音效和多角色对话放进同一个生成过程。
制作时不要将提示词写成单纯的声音形容词列表。
需要像导演给演员讲戏一样,写清楚人物正在经历什么,情绪如何变化,在哪里停顿,什么时候呼吸,以及周围空间正在发生什么。
当人物状态、台词和声音环境真正建立关系后,生成结果才会从普通AI配音,变成一段完整的声音表演。
角色设计执行卡
把这节课压缩成一张可执行卡片:看重点、照步骤、避坑,再复制模板直接开做。
这节课不是让你照着参考图抄脸,而是围绕「刺猬星球super-i_AI教程免费在线教学」把原创角色脸拆成结构、比例、五官主次和妆造记忆点。
按原文节奏走最稳:先吃透「准备工具」,再把「SeedAudio 1.0能做什么?」定住,接着处理「第一章:创建参考音色」;最后用「第二章:人物情绪与状态表演」收口。
- 先把「准备工具」里说的脸型或气质定住。
- 围绕「SeedAudio 1.0能做什么?」收一收五官,不要让每个部位都抢戏。
- 围绕「第一章:创建参考音色」只取局部结构,别整张照搬。
- 先把「第二章:人物情绪与状态表演」里说的脸型或气质定住。
- 围绕「第三章:生成完整环境音效」收一收五官,不要让每个部位都抢戏。
- 做完「第四章:多角色对话与角色分配」后,先确认角色还是原创。
不要直接套真人脸或影视角色脸;不要把所有五官都做成强特征,否则容易撞脸、割裂、不稳定。
检查角色是否有清晰记忆点;年龄感和气质是否一致;换妆造后脸是否稳定;是否不像任何明确真人或影视角色。
请围绕「刺猬星球super-i_AI教程免费在线教学」帮我做一个可直接执行的方案。
我的目标是:【填写你的具体目标】
我的素材/产品/角色信息是:【填写已有素材和限制】

请输出:角色定位、脸型方向、三庭五眼比例、五官主次、妆造记忆点、完整生图提示词。要求原创、有辨识度、避免撞脸和网红脸。